CSV를 열었더니 한글이 깨지는 경우에는 파일이 손상됐다고 결론 내리기 전에 어떤 문자 인코딩으로 읽었는지 확인해야 합니다. 같은 한글 문장도 UTF-8과 CP949에서 서로 다른 바이트가 됩니다. 깨진 글자를 다시 저장하면 처음에는 멀쩡했던 원문까지 바뀔 수 있으므로, 읽기 옵션을 바꾸는 작업과 파일 내용을 고치는 작업을 분리하십시오.
먼저 구분할 조건
텍스트 파일의 인코딩은 글자를 바이트로 표현하는 규칙입니다. 확장자 .csv가 그 규칙까지 지정하지는 않습니다. UTF-8 BOM은 파일 처음의 EF BB BF라는 바이트로 UTF-8 사용을 식별하는 데 도움을 줄 수 있지만, 모든 CSV 프로그램이 BOM을 같은 방식으로 처리하지는 않습니다. 어떤 도구에서는 첫 열 이름 앞에 보이지 않는 문자가 남을 수 있습니다. 한글이 잘 보이는지만 확인하지 말고 첫 열 이름과 데이터 행도 읽어야 합니다.
직접 확인한 예제와 방법
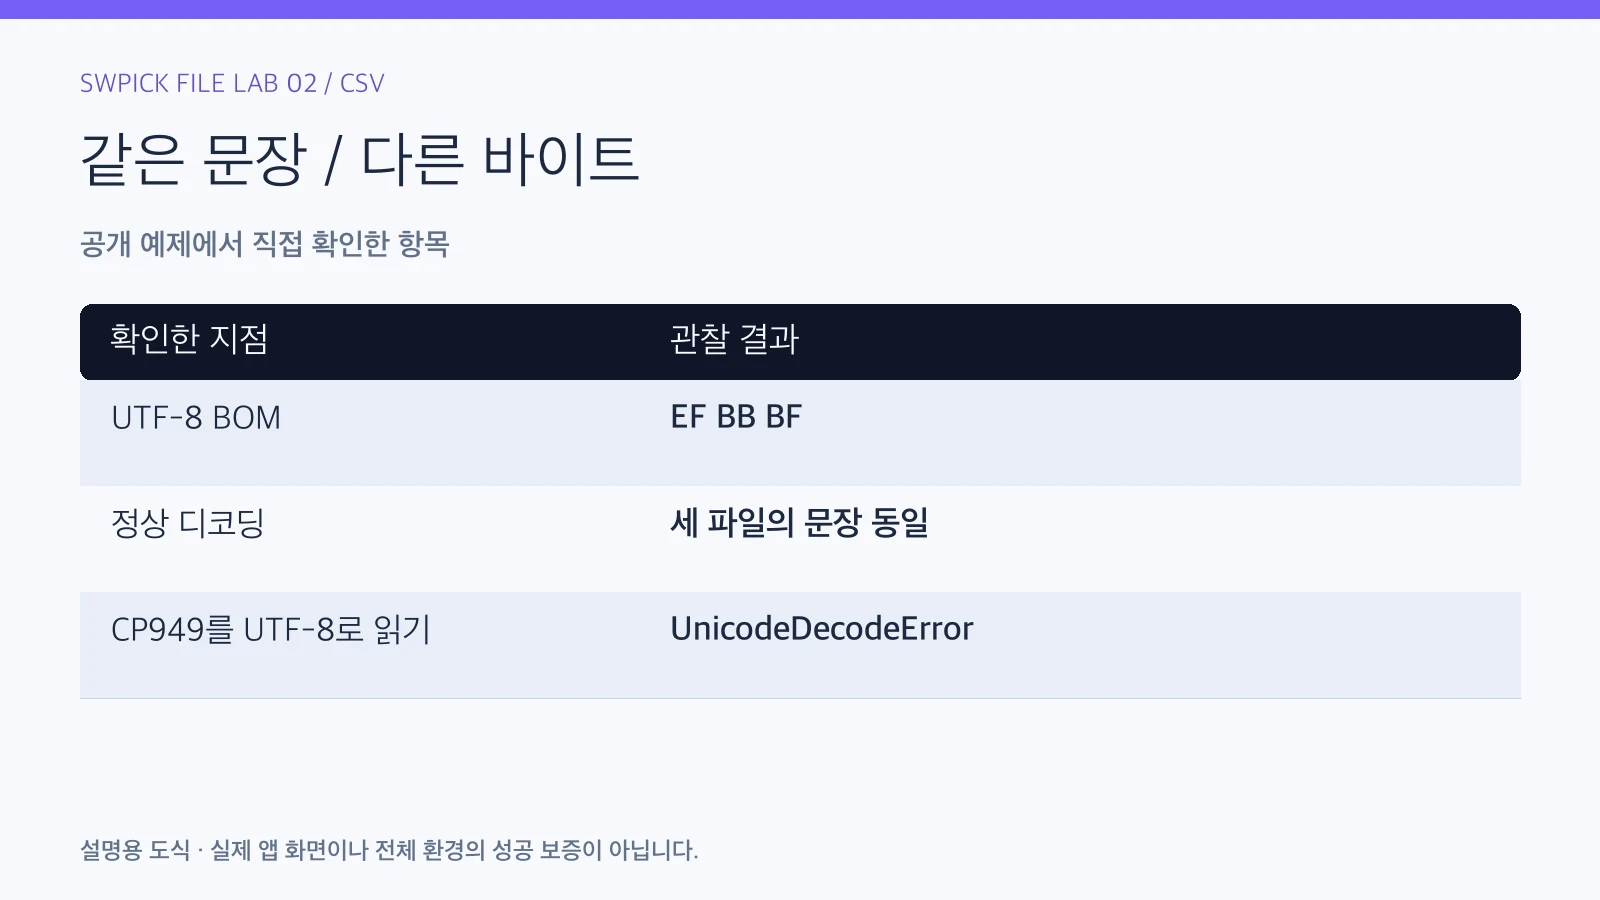
name·amount 헤더와 한글예제라는 가상 이름을 UTF-8, UTF-8 BOM, CP949 세 파일에 저장했습니다. Python 3.12.14에서 각각 utf-8, utf-8-sig, cp949로 다시 읽었을 때 문장이 동일했습니다. BOM 파일의 처음 세 바이트는 EF BB BF였고, CP949 파일을 UTF-8로 엄격하게 읽으면 UnicodeDecodeError가 발생했습니다. 실제 고객 명단은 사용하지 않았습니다. 이번 결과는 같은 문자와 다른 저장 바이트를 구분하는 시험입니다.
| 확인 항목 | 관찰 결과 |
|---|---|
| UTF-8 BOM | EF BB BF |
| 정상 디코딩 | 세 파일의 문장 동일 |
| CP949를 UTF-8로 읽기 | UnicodeDecodeError |
결과를 해석하는 기준
잘못된 인코딩으로 읽었을 때 오류가 나는 것은 유용한 신호입니다. 오류를 무시하거나 깨진 문자를 대체해서 보여 주는 설정에서는 파일이 열린 것처럼 보이지만 일부 문자가 이미 다른 값으로 바뀔 수 있습니다. 변환이 필요한 자료라면 원문을 정확한 규칙으로 먼저 읽은 다음 목표 인코딩으로 별도 파일을 저장해야 합니다.
BOM이 없다고 UTF-8이 아니라고 판단해서는 안 됩니다. UTF-8은 BOM 없이도 사용할 수 있습니다. 반대로 파일 처음에 BOM처럼 보이는 바이트가 있다는 단서만으로 전체 문서가 정상이라고 승인할 수 없습니다. 자료를 만든 프로그램의 내보내기 설정, 헤더, 한글·숫자·특수문자를 함께 확인하는 것이 더 확실합니다.
제공 인코딩과 수신 인코딩이 다른 경우
작성 예제로, 옛 업무 시스템은 CP949를 요구하고 새 분석 도구는 UTF-8을 받는 상황을 생각해 볼 수 있습니다. 먼저 CP949 원문을 정확히 읽고 UTF-8 사본을 따로 만들어야 합니다. 깨진 문장을 현재 화면에서 저장하는 작업을 인코딩 변환이라고 부르면 원래 문자가 바뀐 시점을 놓칩니다.
| 상황 | 확인할 질문 | 먼저 할 일 |
|---|---|---|
| 원본 CP949가 정상 | 원문을 어떤 규칙으로 읽었나 | 정확히 디코딩 후 사본 변환 |
| 한글은 맞고 첫 헤더만 이상 | BOM 문자가 남았나 | 첫 열 이름까지 대조 |
| 깨진 저장본만 있음 | 변환 전 원본이 있는가 | 이전 파일·제공자 재출력 확인 |
전달 규칙에는 UTF-8이라는 이름뿐 아니라 BOM 허용 여부와 구분자도 적으십시오. 인코딩을 맞춘 뒤 행·열·ID가 바뀌지 않았는지 확인해야 실제 자료가 유지됩니다.
내 자료에서 확인할 순서
- 원본 파일을 복사하고 현재 잘못 열린 상태에서 덮어 저장하지 않습니다. 파일 제공자가 어떤 인코딩으로 내보냈는지 알려 줬는지도 확인합니다.
- 스프레드시트의 텍스트 가져오기 미리보기에서 파일 원본·인코딩 선택이 있는지 확인합니다. UTF-8과 해당 자료의 알려진 인코딩을 작은 사본에서 비교합니다.
- 한글이 맞아도 헤더가 정상인지 확인합니다. 첫 열 이름에 예상하지 않은 문자가 붙으면 BOM 처리와 열 이름 비교를 점검합니다.
- 변환 후에는 다른 파일명으로 저장합니다. 원본에서 정상적으로 읽은 문장과 변환본에서 다시 읽은 문장을 대조합니다.
- 숫자 열과 ID 열도 확인합니다. 인코딩이 맞아도 구분자·따옴표·자료형 조건이 틀리면 열이나 앞자리 0이 바뀔 수 있습니다.
- 전달할 때는 파일 이름뿐 아니라 인코딩·구분자·줄바꿈 규칙을 함께 적습니다. 가능한 경우 작은 예제와 정상 헤더를 같이 제공합니다.
잘못 바꾸었거나 확인이 어려울 때
어떤 인코딩으로도 문장이 정상적으로 돌아오지 않으면 이미 다른 규칙으로 읽고 저장한 파일일 수 있습니다. 현재 깨진 문장을 여러 번 변환해 모양만 맞추려 하면 원래 바이트와의 관계를 더 잃습니다. 변환 전 원본이나 제공자의 재내보내기 자료를 확보하는 편이 낫습니다. 기관·회사 시스템에 필요한 특정 인코딩이 있다면 임의로 UTF-8로 통일하기 전에 수신 요구를 확인해야 합니다.
정상 완료 기준
한글·헤더·숫자·구분자가 기대한 값으로 읽히고, 변환본을 다시 열어도 같은 문장이 남아야 합니다. 공개 파일 세 개처럼 저장 방식이 달라도 정확히 디코딩한 내용이 같다는 확인이 있어야 변환 완료로 볼 수 있습니다. 읽기 과정에서 대체 문자나 인코딩 오류를 조용히 넘긴 경우에는 이 기준을 충족했다고 판단하지 않습니다.
같은 예제를 다시 확인할 자료
CP949와 UTF-8만으로 모든 한글 파일을 분류할 수는 없습니다. 실제 파일은 다른 인코딩을 쓰거나 여러 형식의 내용을 섞고 있을 수 있습니다. 이 예제는 바이트를 직접 확인하는 방법을 보여 주며 임의의 파일 인코딩을 항상 자동 추정하는 검사는 아닙니다.
- korean-utf8.csv (33 bytes)
- korean-bom.csv (36 bytes)
- korean-cp949.csv (29 bytes)
자료는 비민감 가상 예제입니다. 손상·불일치라고 표시한 파일은 차이를 확인하는 실험용이며 업무 원본으로 사용하지 않습니다. 파일 크기·SHA-256 목록으로 내려받은 원본을 확인할 수 있습니다.
문자가 정상인데 열이나 행이 틀리면 인코딩과 CSV 구조를 따로 봐야 합니다. 기존 CSV의 ID별 관계 비교에서도 원문 형식을 보존하는 이유를 확인할 수 있습니다.