길게 이어진 주문번호가 마지막 몇 자리에서 바뀌면 셀 너비나 지수 표기만의 문제인지 먼저 살펴야 합니다. ID를 숫자로 바꾸는 과정에서 정밀도를 잃었다면 표시 형식을 늘려도 원래 자리는 돌아오지 않습니다. Microsoft는 Excel 숫자 정밀도의 범위를 설명하므로, 계산할 수량과 보존할 식별자를 나눠 가져오는 것이 중요합니다.
먼저 구분할 조건
주문번호는 길이가 길어도 사칙연산의 대상이 아닐 수 있습니다. 앞자리 0, 하이픈, 끝자리 차이 모두 다른 주문을 구분하는 문자일 수 있습니다. 과학적 표기법으로 짧게 표시된 숫자가 내부에는 정확히 남아 있는 경우도 있지만, 실제 값이 이미 반올림된 경우도 있습니다. 두 상황은 원문 문자열과 저장된 값의 전체 자릿수를 비교해야 구분할 수 있습니다.
직접 확인한 예제와 방법
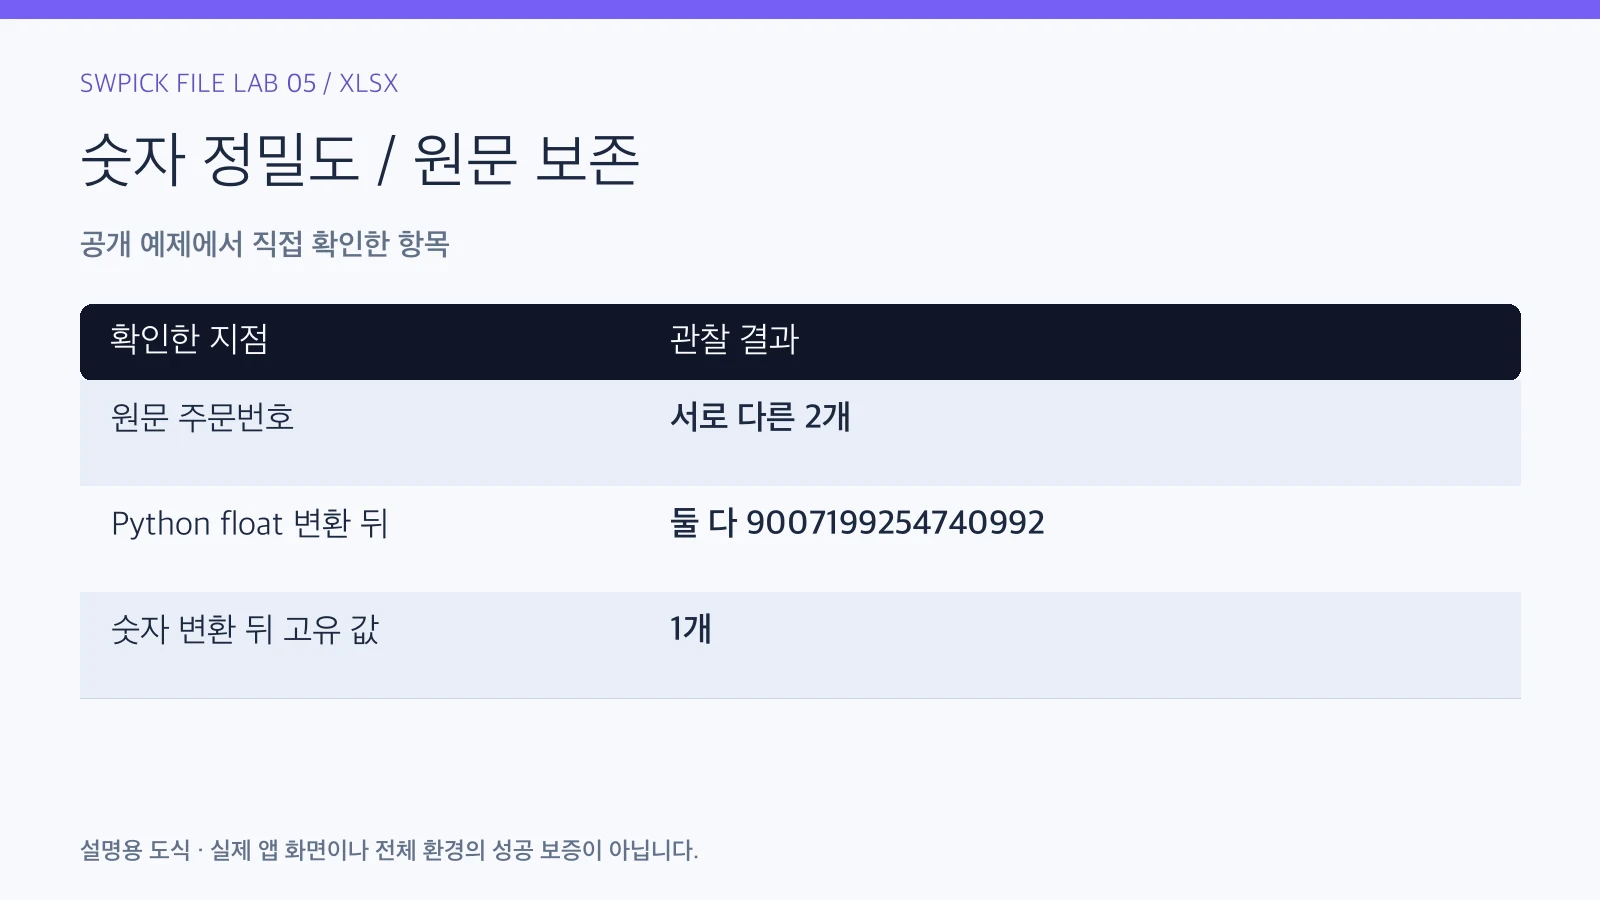
가상 ID 9007199254740992와 9007199254740993을 CSV 문자열로 보존했습니다. Python 3.12.14에서 원문 두 개는 서로 달랐습니다. 같은 문자열을 float로 바꾸고 정수로 읽으면 둘 다 9007199254740992가 되어 고유 값이 한 개로 줄었습니다. 이는 Python의 부동소수점 변환 실험입니다. Excel이 같은 자리에서 같은 결과를 낸다는 시험은 아니며, Excel의 15자리 정밀도 조건은 Microsoft 공식 자료의 별도 근거로 구분합니다.
| 확인 항목 | 관찰 결과 |
|---|---|
| 원문 주문번호 | 서로 다른 2개 |
| Python float 변환 뒤 | 둘 다 9007199254740992 |
| 숫자 변환 뒤 고유 값 | 1개 |
결과를 해석하는 기준
숫자로 바뀐 뒤 같은 값이 된 두 ID를 중복 주문이라고 제거하면 실제로 다른 레코드를 잃을 수 있습니다. 원문이 남은 시점에서 문자열 형태의 고유 ID와 자료형을 보존해야 합니다. 현재 숫자 값을 문자열로 다시 바꾸는 작업은 그 숫자를 글자로 표현할 뿐, 변환 전에 달랐던 마지막 자리를 알아내지는 못합니다.
지수 표기가 보인다는 이유만으로 모든 자료가 손상된 것은 아닙니다. 표시 방식과 값의 정밀도를 각각 검사하세요. Microsoft의 숫자 보관 조건, 브라우저 JavaScript의 안전한 정수 범위, Python float의 결과를 하나의 동일한 경계처럼 설명해서도 안 됩니다. 사용하는 엔진이 어떤 방식으로 ID를 해석하는지 실제 원문과 대조하는 것이 우선입니다.
표시만 짧아진 값과 실제 정밀도 손실
작성 예제로 1.234E+15처럼 보이는 셀을 생각해 볼 수 있습니다. 표시만 짧아졌다면 원문과 전체 저장 값이 같을 수 있습니다. 반대로 숫자 변환으로 끝자리가 이미 같아진 두 ID는 화면을 넓히거나 문자로 다시 바꿔도 원래 차이가 돌아오지 않습니다.
| 상황 | 확인할 질문 | 먼저 할 일 |
|---|---|---|
| 지수 표기만 보임 | 전체 값은 원문과 같은가 | 표시와 저장 값을 각각 비교 |
| 다른 ID가 같은 숫자가 됨 | 변환 전 문자열이 남았나 | 원문으로 연결 관계 복구 |
| 고유 값 수가 줄어듦 | 어느 단계에서 숫자로 바뀌었나 | 입력·전달 경로를 나눠 확인 |
손상된 값으로 중복 제거를 실행하지 않는 것이 중요합니다. 원문 ID가 없는 자료에서는 추정해 새 주문번호를 만드는 대신 제공자의 정상 자료를 확보해야 합니다.
내 자료에서 확인할 순서
- 긴 ID가 있는 원본을 복사하고 일반 텍스트에서 전체 자릿수를 확인합니다. 업무 자료를 숫자 앱에 다시 저장하기 전에 원문을 확보합니다.
- ID 열은 텍스트로 가져올 조건을 지정합니다. 수량·금액 열의 숫자 계산과 분리하고, ID의 입력 규칙을 자료 제공자와 맞춥니다.
- 눈으로 다른 끝자리를 가진 작은 가상 예제를 먼저 가져옵니다. 가져온 값의 전체 문자열이 원문과 같은지 확인합니다.
- 중복 검사는 원문이 보존된 ID로 합니다. 숫자로 자동 변환된 ID에서 고유 값이 줄었다면 먼저 자료형 손실을 의심합니다.
- 다른 시스템으로 내보낸 뒤에도 문자열 자릿수를 대조합니다. API·CSV·데이터베이스가 중간에 숫자로 바꾸지 않았는지 확인합니다.
- 손상이 발견되면 현재본을 덮어쓰지 말고 원문·변환본·영향 행 목록을 같이 보존합니다. 복원은 신뢰 가능한 원본 ID와 연결해서 진행합니다.
잘못 바꾸었거나 확인이 어려울 때
원본이 없는데 끝자리만 비슷한 ID를 임의로 추정하면 다른 주문으로 연결할 수 있습니다. 표시 자릿수를 늘리거나 문자열 함수로 0을 붙이는 방식은 정밀도 손실 복구가 아닙니다. 신뢰 가능한 이전 파일·제공자 원본·변경 이력에서 값을 확보해야 합니다. 실제 고객·결제 식별자는 이 실험의 공개 예제에 넣지 말고 사본에서 필요한 형식만 확인하십시오.
정상 완료 기준
원문과 현재 ID가 문자 단위로 일치하고, 서로 다른 두 ID가 여전히 두 개로 구분되며, 다시 출력한 파일에도 그 차이가 남아야 합니다. ID의 자릿수와 자료형 규칙을 전달 과정에 기록하면 다음 작업자가 자동 숫자 변환을 반복하는 일을 줄일 수 있습니다. 합계나 행 수만으로 이 기준을 대체할 수는 없습니다.
같은 예제를 다시 확인할 자료
공개 CSV의 숫자는 실제 주문이나 개인 식별 정보가 아닙니다. Python 변환과 공식 문서의 범위를 구분해 설명했습니다. 특정 Excel 앱에서 입력·저장·재열기의 모든 동작을 실행한 결과나 모든 숫자 엔진에 적용되는 동일 임계값을 주장하지 않습니다.
- long-order-ids.csv (43 bytes)
자료는 비민감 가상 예제입니다. 손상·불일치라고 표시한 파일은 차이를 확인하는 실험용이며 업무 원본으로 사용하지 않습니다. 파일 크기·SHA-256 목록으로 내려받은 원본을 확인할 수 있습니다.
앞자리 0과 ID별 연결 관계는 기존 CSV 검사 예제에서도 따로 확인할 수 있습니다.