검색어를 그대로 복사했는데 일치하지 않거나 두 ID가 눈으로는 같은데 서로 다르다면 보이지 않는 문자가 섞였는지 확인해 볼 수 있습니다. 일반 공백, 줄바꿈 없는 공백, 폭 없는 공백은 서로 다른 문자입니다. 화면에서 차이를 찾기 어렵다고 원본을 모두 정리해 버리면 정상적인 띄어쓰기나 식별자까지 바뀔 수 있으므로 영향을 받는 범위를 먼저 정해야 합니다.
먼저 구분할 조건
공백처럼 보이는 문자마다 줄바꿈·폭·비교의 역할이 다릅니다. U+0020은 일반 공백, U+00A0은 줄바꿈 없는 공백, U+200B는 폭 없는 공백으로 구분됩니다. 웹페이지·문서·메신저에서 복사한 문자열은 눈에 보이는 글자 외에도 이런 정보를 포함할 수 있습니다. 모든 공백을 제거하면 되는 문제인지, 원문의 의미를 보존해야 하는 문제인지 확인해야 합니다. 비밀번호나 실제 고객 ID는 공개 검사창에 넣지 말고 가상 문자열로 형식만 비교하십시오.
직접 확인한 예제와 방법
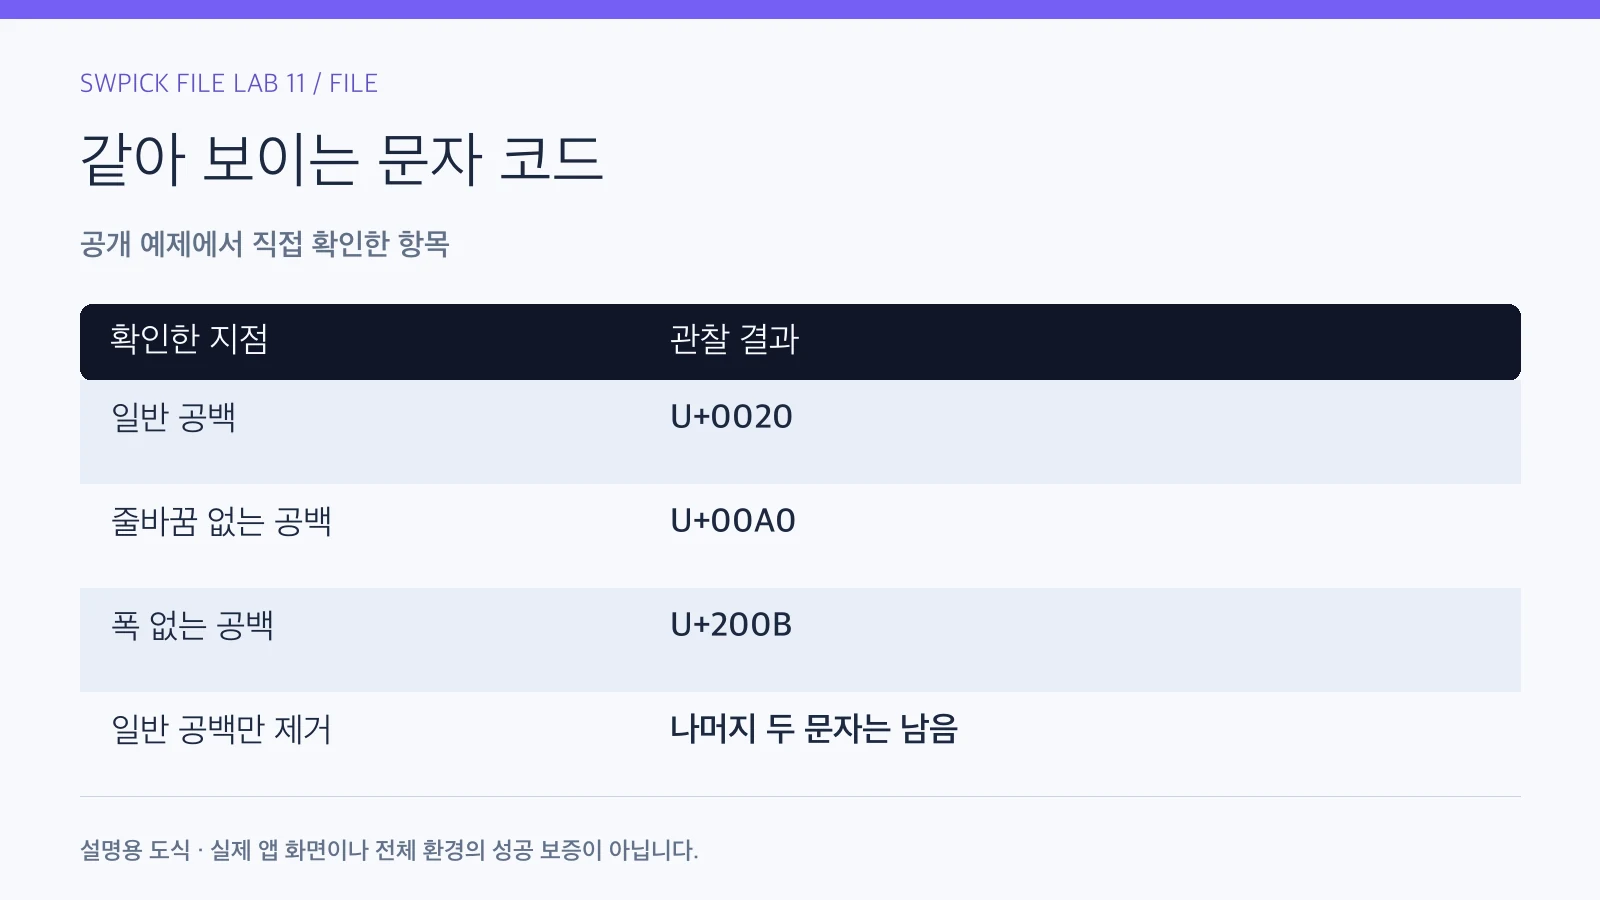
A와 B 사이에 세 종류의 문자를 각각 넣은 UTF-8 텍스트를 만들었습니다. Python 3.12.14에서 문자별 코드 포인트를 읽어 가운데 값이 0020·00A0·200B라는 것을 확인했습니다. 일반 공백 U+0020만 빈 문자열로 바꾸면 첫 예제는 AB가 되지만 나머지 두 문자는 남았습니다. 이는 특정 앱 검색기의 동작 시험이 아니라 문자열에 들어 있는 문자가 다르다는 직접 확인입니다.
| 확인 항목 | 관찰 결과 |
|---|---|
| 일반 공백 | U+0020 |
| 줄바꿈 없는 공백 | U+00A0 |
| 폭 없는 공백 | U+200B |
| 일반 공백만 제거 | 나머지 두 문자는 남음 |
결과를 해석하는 기준
단순히 replace(" ", "")를 적용하는 도구는 일반 공백을 대상으로 할 수 있습니다. 그런 처리를 한 뒤에도 값이 다르다고 원인 없이 새로운 문자들을 계속 지우지 마세요. 어떤 코드 포인트가 들어 있는지와 그것을 보존해야 하는 이유를 먼저 읽어야 합니다. 자료가 업무 규칙상 공백을 허용하지 않는 ID인지, 정상 문장인지에 따라 조치가 다릅니다.
trim 계열 기능도 보통 문자열 양끝의 공백을 처리하는 목적이며 가운데 문자 전체를 정리하는 기능과 같지 않습니다. 처리하는 공백 종류는 언어·함수의 정의를 확인해야 합니다. 프로그램이 알아서 같은 문자로 취급할 것이라고 기대하면 검색·중복 판정·연결 키에서 결과가 달라질 수 있습니다.
문장의 공백과 ID의 허용 문자를 나눕니다
작성 예제로 영문 제품 이름 안의 줄바꿈 없는 공백은 단어를 붙여 표시하려는 의도일 수 있습니다. 반면 공백을 허용하지 않는 ID에 같은 문자가 끼면 연결 오류가 될 수 있습니다. 같은 문자라도 정리할지 보존할지 업무 규칙을 먼저 확인해야 합니다.
| 상황 | 확인할 질문 | 먼저 할 일 |
|---|---|---|
| 일반 문장의 NBSP | 표시 의도가 필요한가 | 원문 의미를 보존해 검토 |
| ID에 불허 문자가 있음 | 허용 문자 규칙이 있는가 | 사본에서 명시한 문자만 처리 |
| 정리 뒤 같은 값이 생김 | 원래 다른 레코드인가 | 대량 중복 제거를 중단 |
보이지 않는 문자를 제거한 뒤 고유 값 개수를 비교하십시오. 검색이 잘 된다는 결과만으로 원문 식별자의 의미까지 보존됐다고 판단하지 않습니다.
내 자료에서 확인할 순서
- 문제 원문과 복사·입력된 값을 각각 보존하고 어느 단계에서 값이 달라졌는지 기록합니다. 원문을 덮어 정리하기 전에 작은 사본을 만듭니다.
- 문자열 길이와 코드 포인트를 읽을 수 있는 방법으로 대표 예제를 확인합니다. 눈에 보이는 글자 수만으로 동일성을 판단하지 않습니다.
- 일반 공백과 U+00A0·U+200B 같은 문자가 어디에 있는지 구분합니다. 줄바꿈이나 이름 표기의 의미가 있는지도 살핍니다.
- 업무 ID라면 허용 문자와 정리 규칙을 먼저 정의합니다. 문장이라면 읽기 의미를 바꾸지 않는 범위에서 처리합니다.
- 명시한 문자만 사본에서 바꾸고 검색·고유 값·연결 관계가 기대대로 유지되는지 비교합니다. 새로 같은 값이 된 ID가 없는지도 확인합니다.
- 정리한 문자열을 다시 저장하고 대상 프로그램에서 재확인합니다. 복사 경로가 반복해서 같은 문자를 넣으면 입력 방식도 함께 점검합니다.
잘못 바꾸었거나 확인이 어려울 때
이름·제품 코드·다국어 문장을 모두 같은 규칙으로 정리하면 원래 다른 값을 합칠 수 있습니다. 대량 자료에서 공백 제거 후 중복이 생기면 바로 삭제하지 말고 원문 두 개를 비교해야 합니다. 보이지 않는 문자 외에도 대소문자·정규화·검색 범위 차이가 원인일 수 있으므로 한 가지 가설에 맞춰 모든 값을 바꾸지 않습니다.
정상 완료 기준
정상 완료는 불필요한 문자를 정의한 규칙에 따라 처리했고, 필요한 문장과 식별자가 보존되며, 검색·비교·저장 후에도 같은 결과가 나오는 상태입니다. 공개 파일에서는 가운데 문자 세 종류가 서로 다르게 기록돼야 합니다. 화면 모양이 비슷하다는 사실과 저장된 문자가 같다는 사실을 구분하는 것이 목표입니다.
같은 예제를 다시 확인할 자료
예제는 세 코드 포인트만 비교했습니다. 유니코드의 모든 공백·제어 문자·검색 엔진 규칙을 자동으로 판단하는 도구는 아닙니다. 실제 프로그램의 검색이 어떤 정규화나 공백 처리를 하는지는 별도로 확인해야 합니다.
- invisible-spaces.txt (15 bytes)
자료는 비민감 가상 예제입니다. 손상·불일치라고 표시한 파일은 차이를 확인하는 실험용이며 업무 원본으로 사용하지 않습니다. 파일 크기·SHA-256 목록으로 내려받은 원본을 확인할 수 있습니다.
파일 내용의 동일성 자체가 필요한 상황은 전체 바이트와 해시 비교 실험에서 다른 기준으로 확인할 수 있습니다.